Claude Token zählen lohnt sich. Dieselbe deutsche Seite braucht bei Claude gut doppelt so viele Token wie bei GPT. Was das je Text kostet.
Ende September hat eine Forschergruppe unter dem Titel „The Tokenizer Tax“ gemessen, was Sprachen bei KI-Modellen kosten, auf Deutsch Token-Steuer. Die Coalition for Language Equity in AI Research, kurz CLEAR, hat in ihrem Bericht vom 29.09.2026 gezählt, in wie viele Stücke Sprachmodelle dieselbe Übersetzung in verschiedenen Sprachen zerlegen. Die Anbieter rechnen nach diesen Stücken ab, den Token. Wir arbeiten jeden Tag mit Claude. Deshalb habe ich am 06.11.2026 selbst nachgezählt, mit dem Studientext von CLEAR und mit Auszügen aus Beiträgen des JR-Blogs. Dieselbe deutsche Seite braucht bei Claude gut doppelt so viele Token wie bei GPT von OpenAI. Für Englisch zählt Claude das 1,5- bis 1,6-Fache von GPT, Deutsch vergrößert den Abstand auf das Doppelte.
Das Wichtigste in Kürze
- Braucht Deutsch bei Claude mehr Token als bei GPT? Ja. Derselbe deutsche Text brauchte bei Claude 2,0- bis 2,1-mal so viele Token (Zählung vom 06.11.2026, vier JR-Blog-Auszüge und der Studientext).
- Wie viel mehr Token braucht Deutsch als Englisch? Bei Claude 46 bis 72 Prozent mehr, bei GPT 6 bis 30 Prozent.
- Was heißt das für die Kosten? Claude Sonnet 5.5 und GPT-6.1 Sol kosten je Token gleich viel. Für denselben deutschen Text zahlt man bei Sonnet gut das Doppelte, beim größeren Opus 5.5 rund das Vierfache.
- Wie finde ich heraus, was meine Texte kosten? Drei eigene Texte durch beide Zählwerkzeuge schicken und die Kosten je Text vergleichen.
Claude zerlegt dieselbe Seite in doppelt so viele Stücke
Den Text zerlegt ein Tokenizer, ein kleines Programm vor dem Sprachmodell. Ich habe den Studientext FLORES-200 mit 997 Sätzen gezählt, den auch CLEAR nutzt, und vier Auszüge aus Beiträgen des JR-Blogs von JANDA+ROSCHER, kurz Blogtexte: Mistral Large 4, Ein Rucksack voll Bairisch und zweimal php2shell, jeweils mit englischer Fassung. Claude lief über die Zählschnittstelle von Anthropic, GPT über tiktoken, die freie Zählbibliothek von OpenAI. Sie bildet den Tokenizer o200k nach, den GPT seit GPT-4o nutzt. Für GPT-6.1 Sol nehme ich das an.
Beim Studientext brauchte Claude für Deutsch 2,11-mal so viele Token wie GPT, für Englisch 1,60-mal so viele. Bei den Blogtexten waren es 2,04 und 1,48. Beide Zähler bekamen Byte für Byte denselben Text. Bei mir zählten alle aktuellen Claude-Modelle jeden Text gleich. Das gilt für Opus, Sonnet, Haiku und Fable, mit höchstens zwei Token Abweichung.
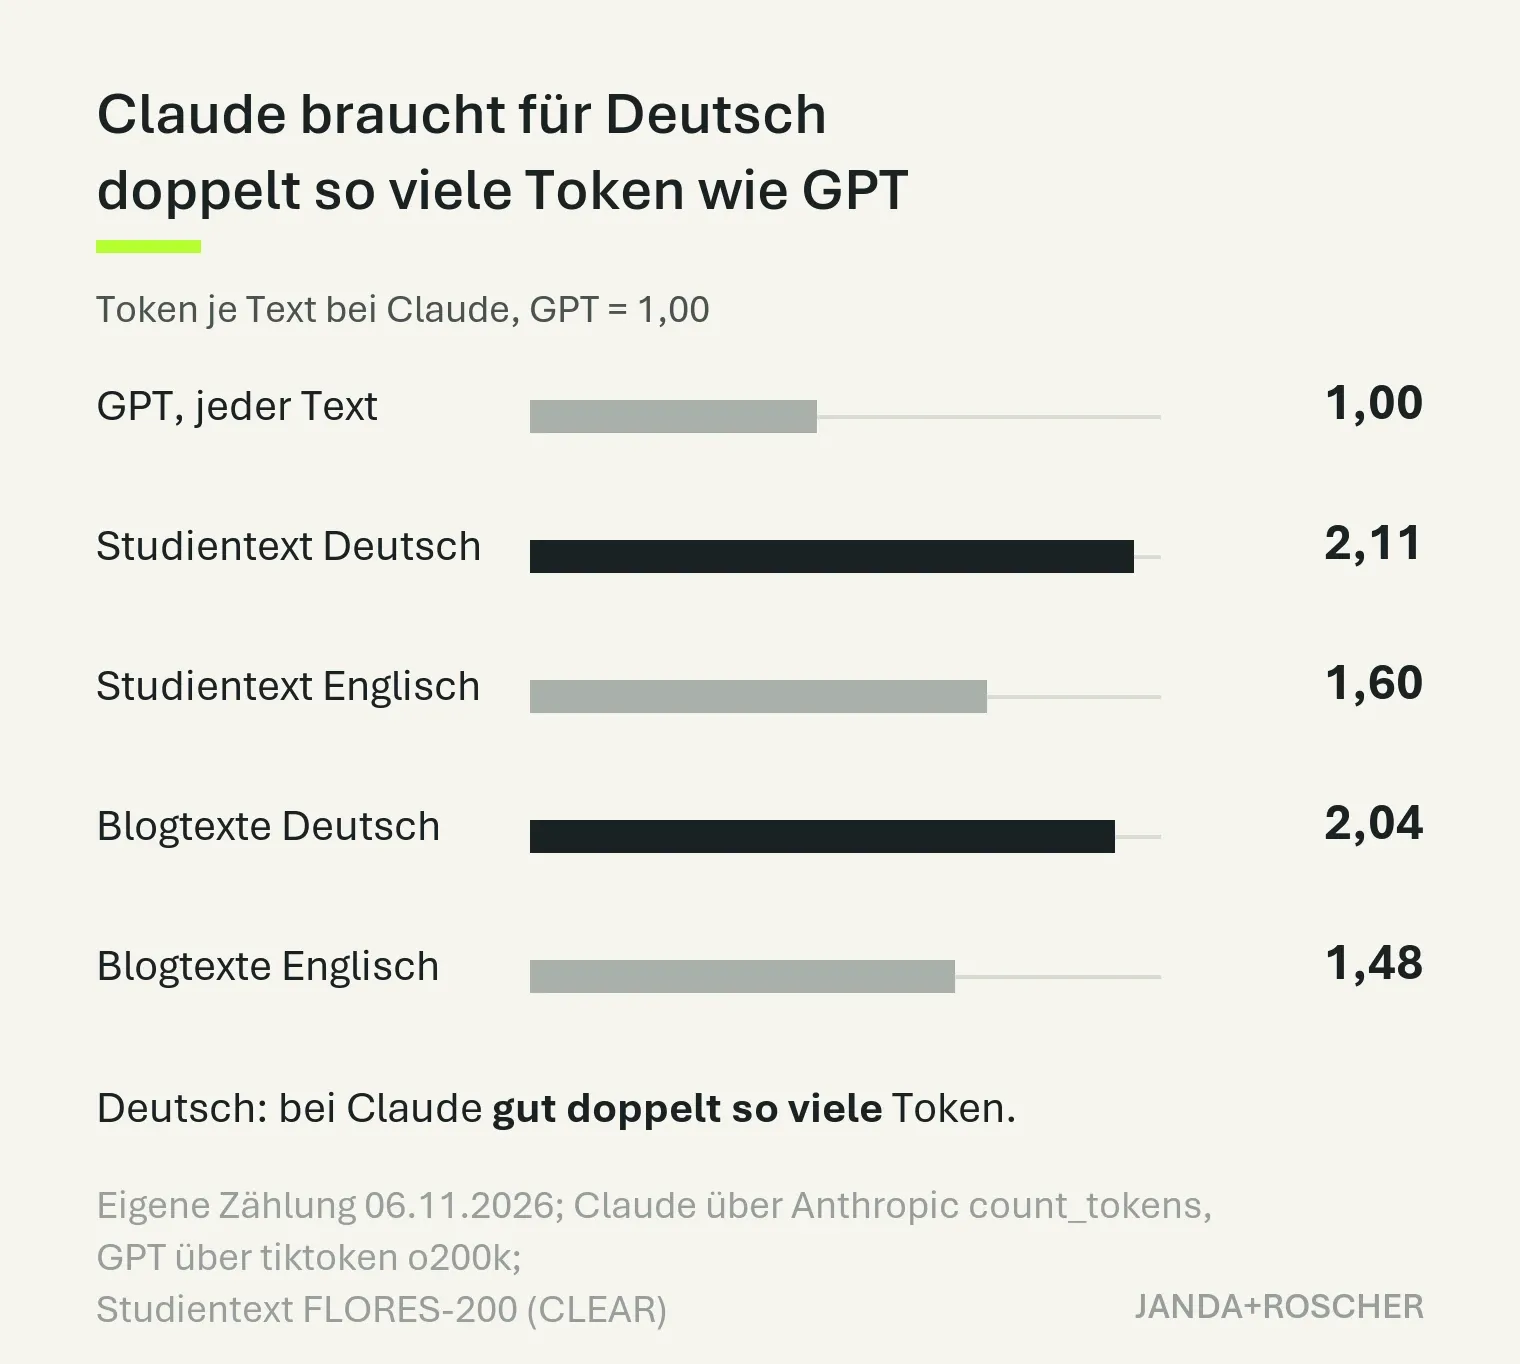 Token je Text bei Claude, GPT gleich 1,00. Eigene Zählung vom 06.11.2026.
Deutsch braucht bei Claude bis zu 72 Prozent mehr Token als Englisch, bei GPT bis zu 30
Im Bericht von CLEAR fand ich Deutsch gar nicht, erst in den Rohdaten auf GitHub. Beim Studientext braucht Deutsch bei Claude 1,72-mal so viele Token wie Englisch, bei GPT 1,30-mal so viele. Bei den Blogtexten sind es 1,46 und 1,06.
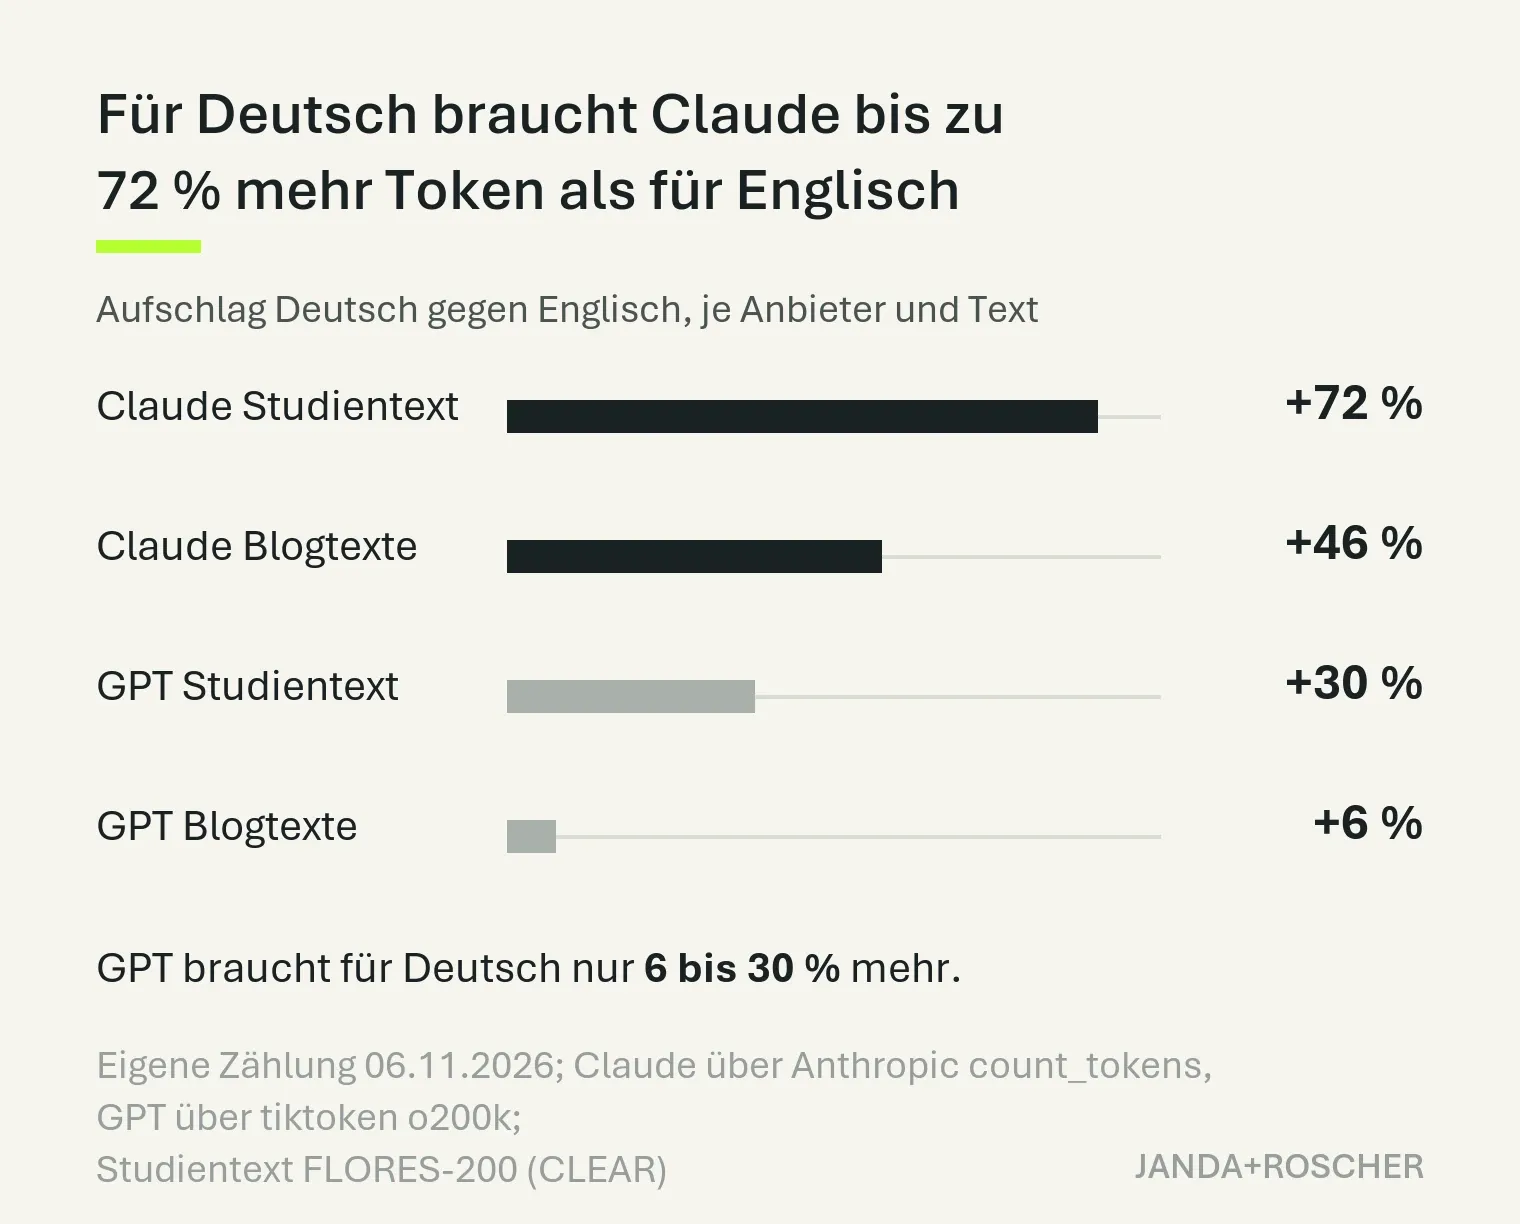 Aufschlag Deutsch gegen Englisch, je Anbieter und Text. Eigene Zählung vom 06.11.2026.
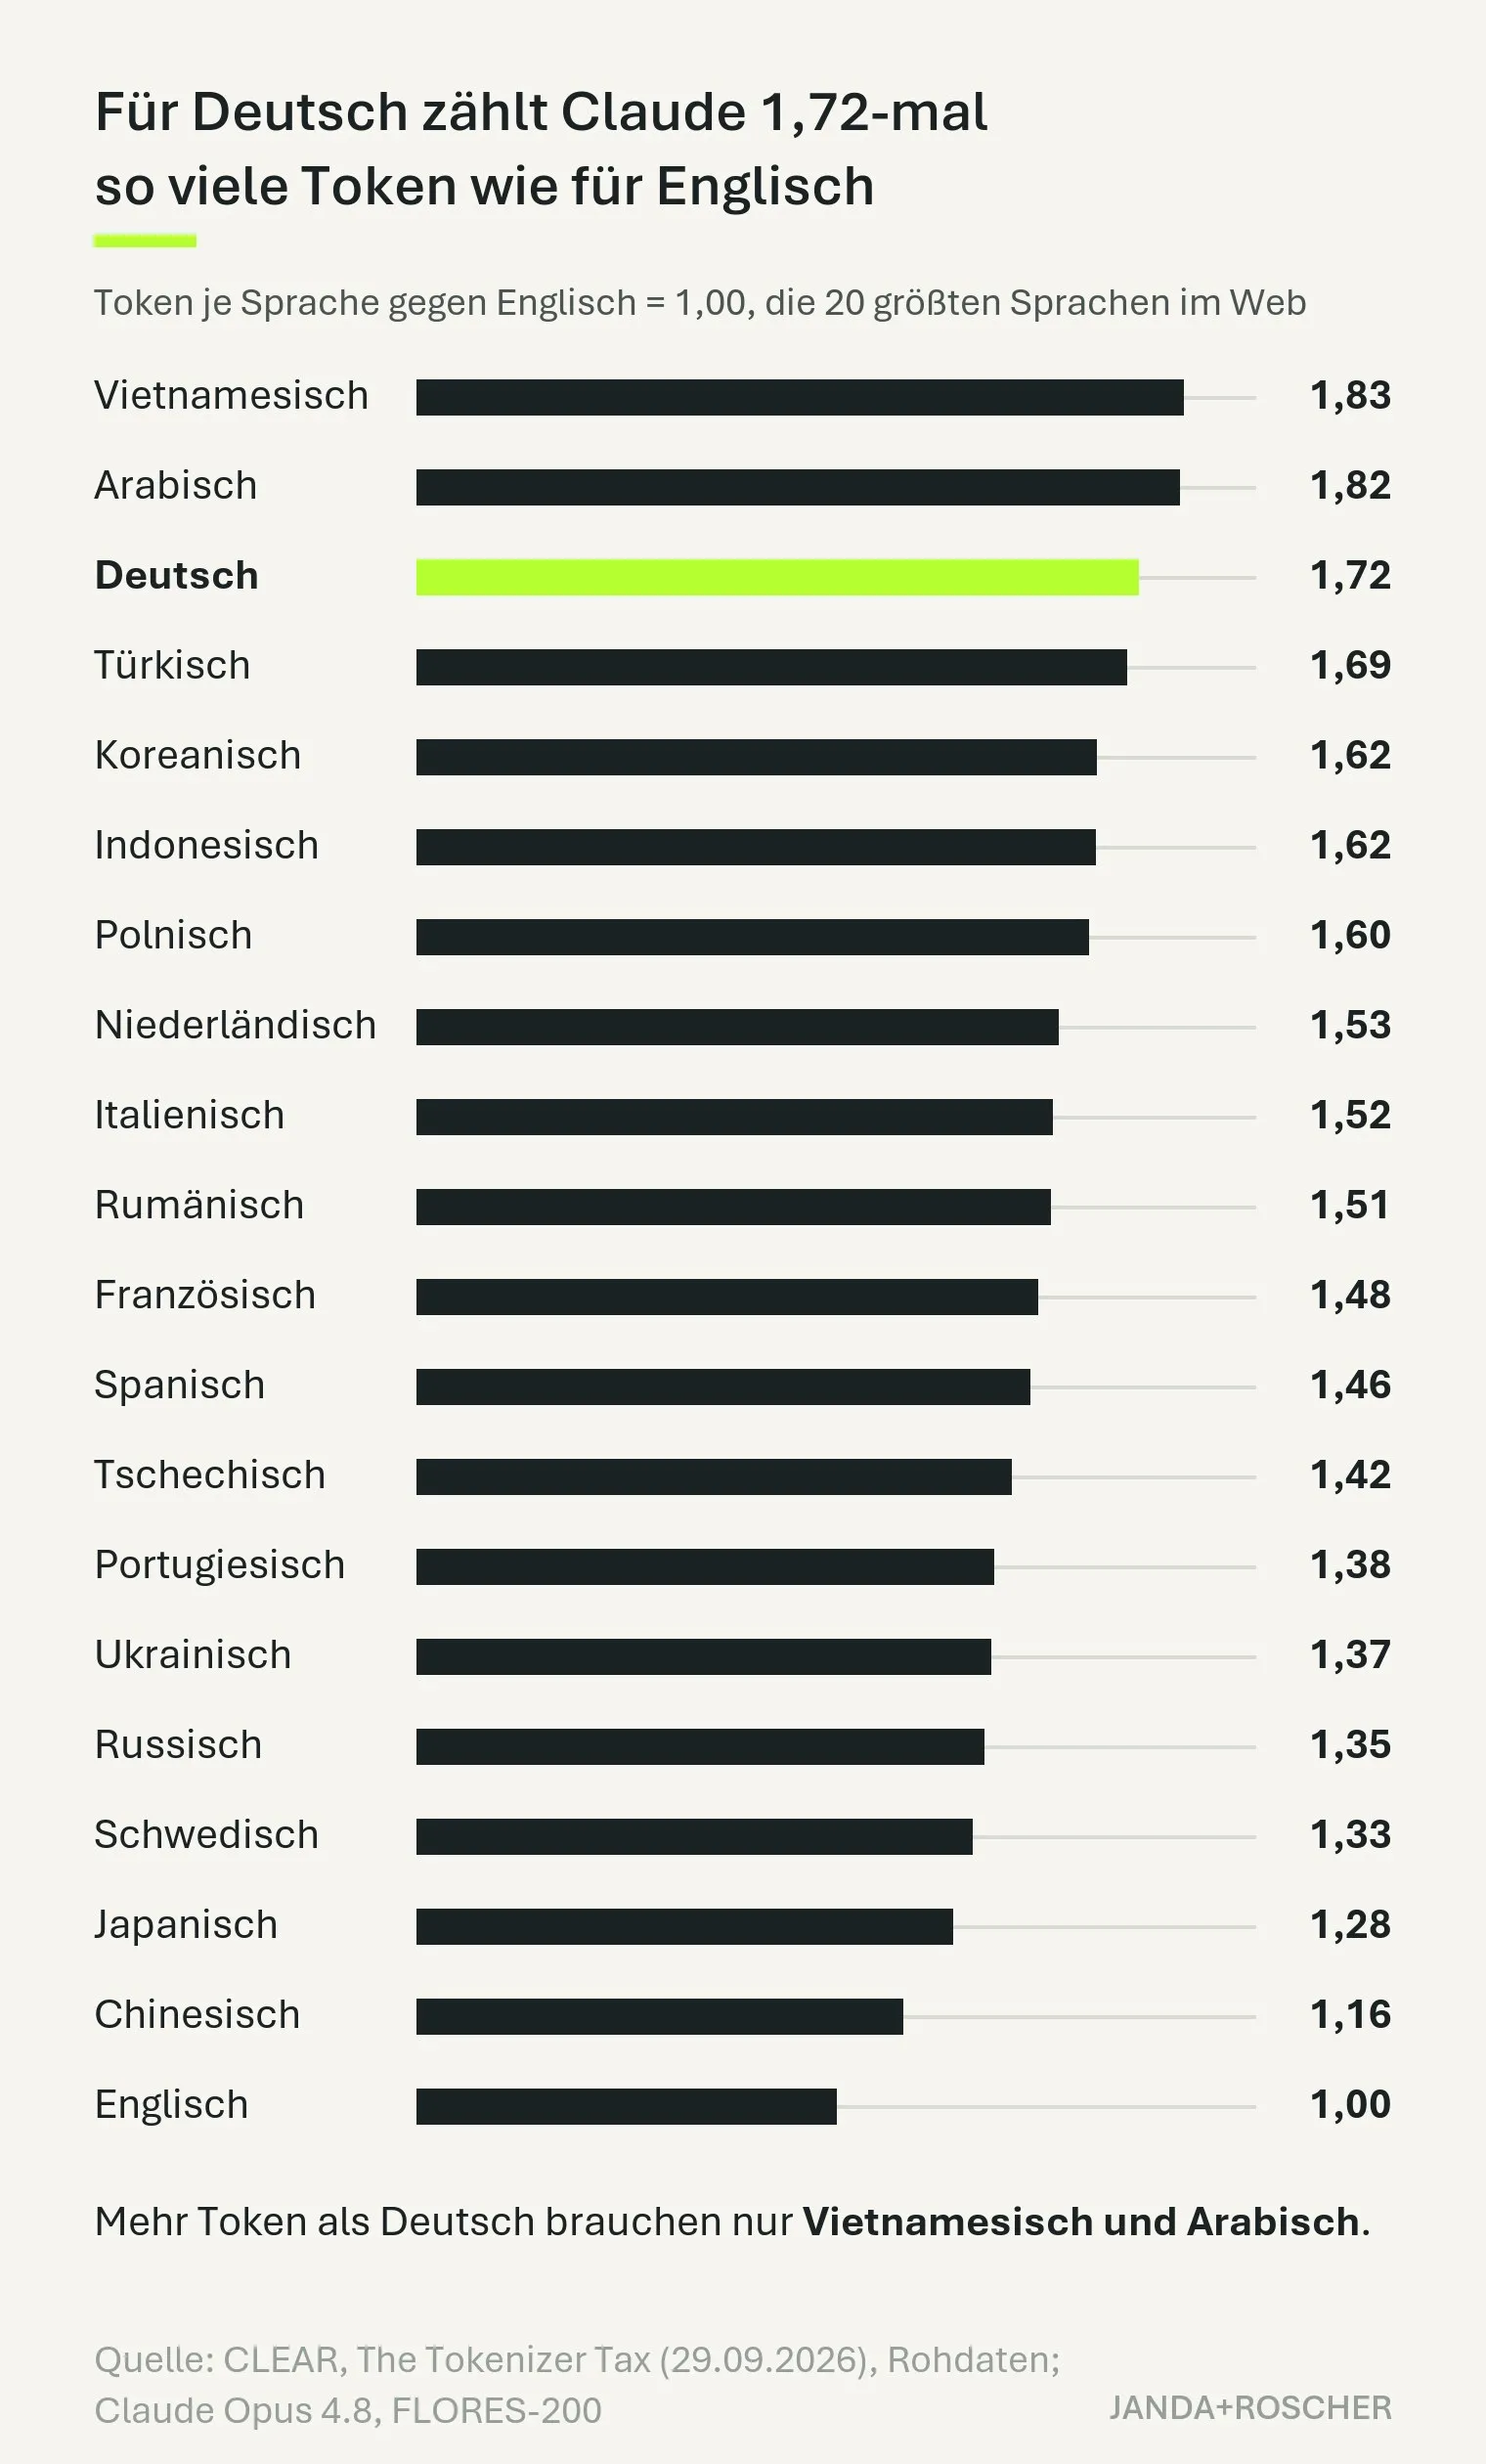 Unter den 20 größten Sprachen im Web braucht bei Claude nur Vietnamesisch und Arabisch mehr Token als Deutsch, gemessen am Studientext FLORES-200.
Deutsche Wörter sind länger, im Studientext hat die deutsche Fassung bei fast gleicher Wortzahl 17 Prozent mehr Zeichen. Dazu zerlegt der Tokenizer deutsche Wortteile feiner, weil Tokenizer laut CLEAR vor allem Englisch und wenige große Sprachen gesehen haben. Bei den Blogtexten fällt der Aufschlag kleiner aus. Die englische Fassung hat fast so viele Zeichen wie das Original.
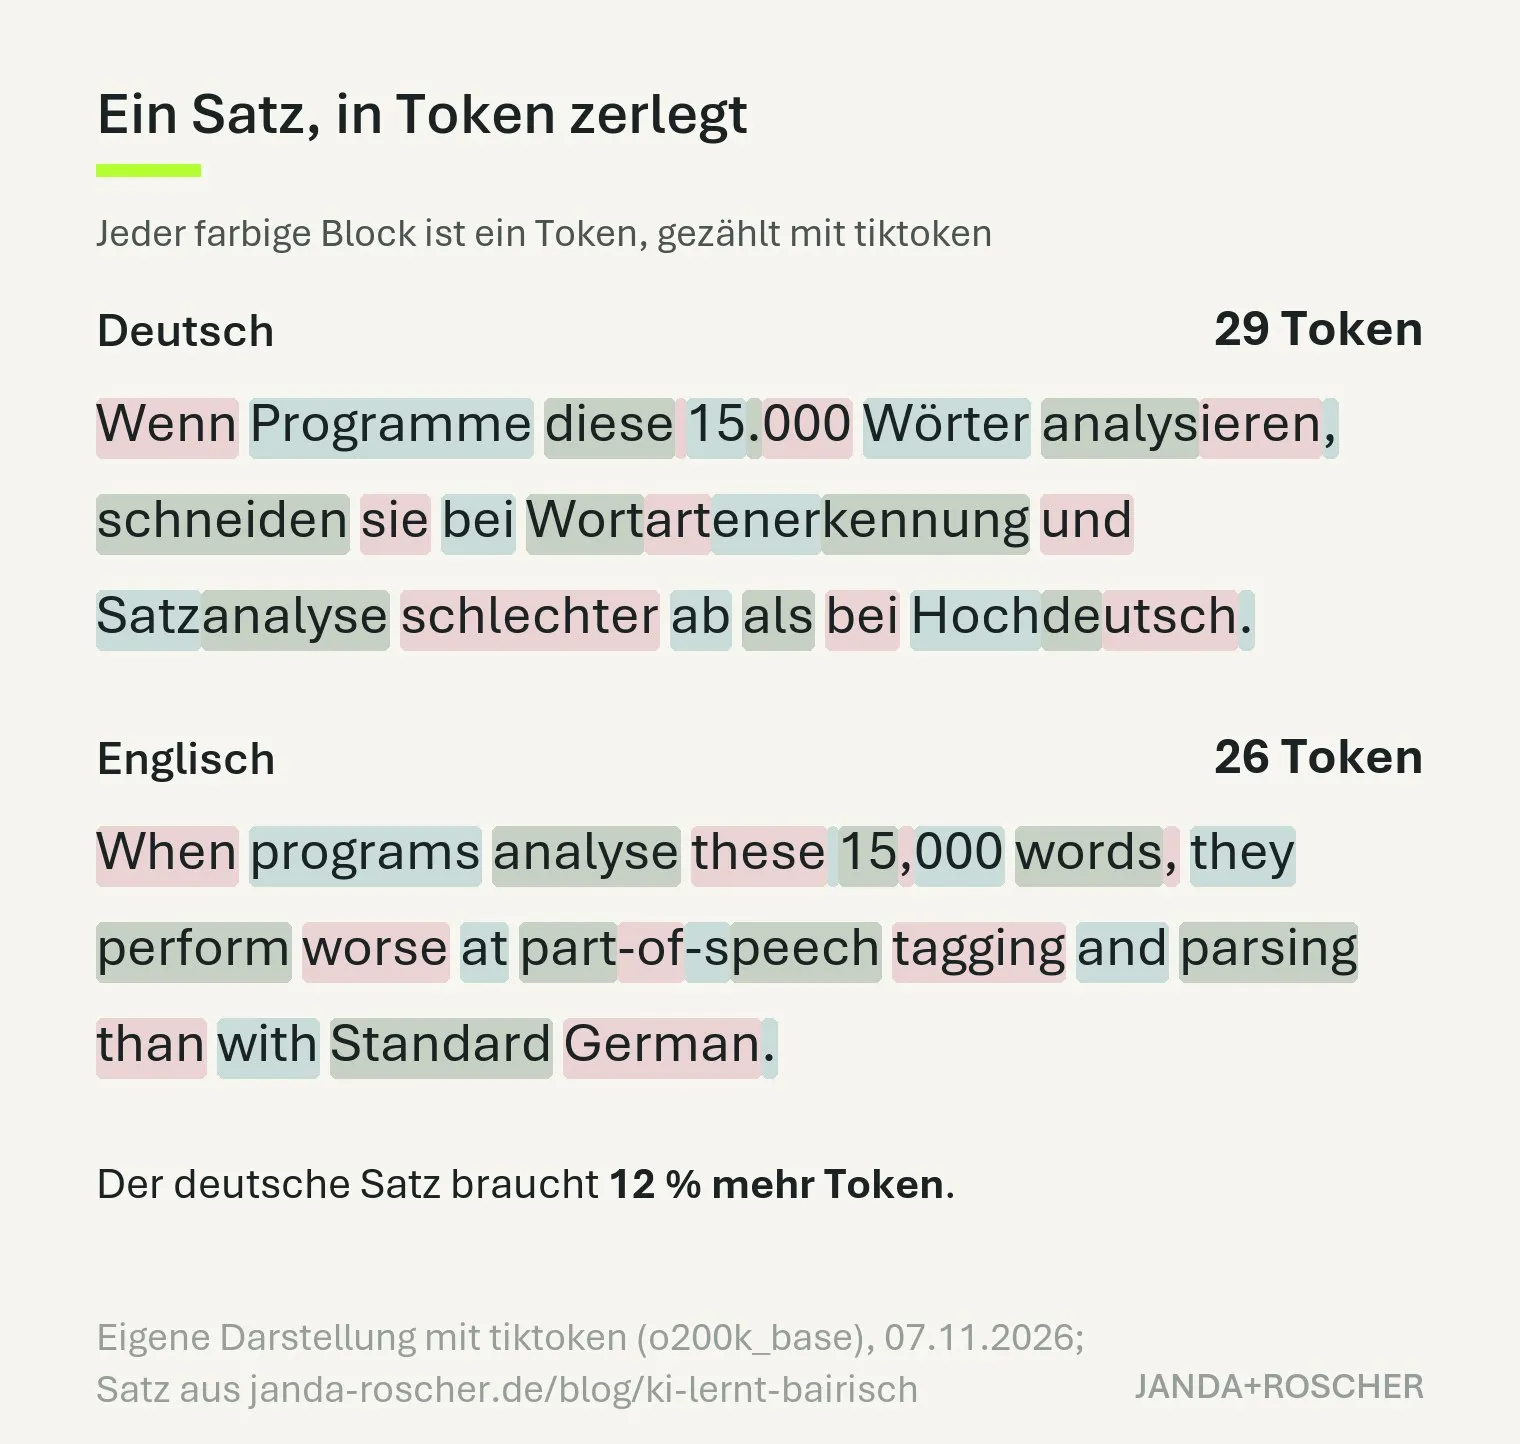 So zerlegt der Tokenizer von GPT einen Satz aus unserem Blog, das lange Wort Wortartenerkennung wird zu vier Token.
Der Aufschlag füllt auch das Kontextfenster schneller, also die Textmenge, die ein Modell auf einmal erfasst. Bei Claude passt weniger Deutsch hinein. Es sind nur 58 Prozent des englischen Inhalts. Dass Modelle mit selten geschriebenen Sprachen schlechter umgehen, habe ich beim Bairisch beschrieben. Bei solchen Sprachen misst CLEAR bei einem Modell das 17-Fache zwischen der Sprache mit den wenigsten und der mit den meisten Token.
Gleicher Preis je Token, doppelte Rechnung
Claude Sonnet 5.5 und GPT-6.1 Sol kosten je Million Token dasselbe, 2 Dollar für die Eingabe und 10 Dollar für die Ausgabe, laut den Preisseiten von Anthropic und OpenAI, abgerufen am 05. und 07.11.2026. Anthropic schreibt dort selbst, sein Tokenizer ab Claude 4.7 erzeuge für denselben Text etwa 30 Prozent mehr Token als der alte. Das ist Claude neu gegen Claude alt, nicht gegen GPT.
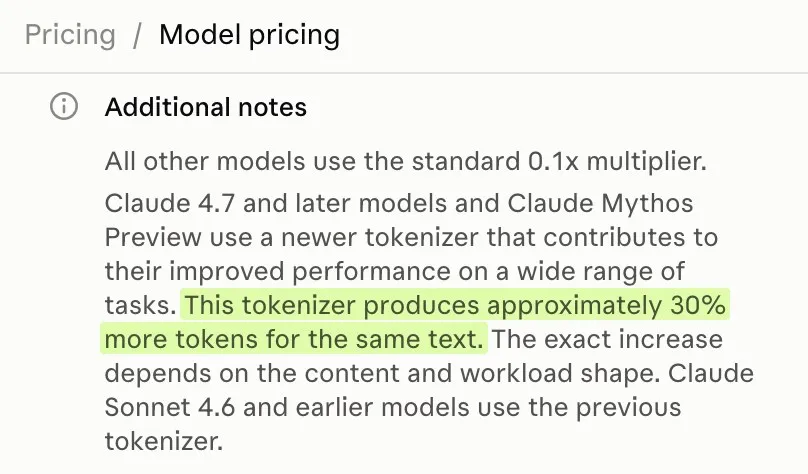 Anthropic nennt auf der eigenen Preisseite rund 30 Prozent mehr Token für denselben Text, gemessen gegen den eigenen älteren Tokenizer. Markierung von uns, Quelle Anthropic, Preisseite, Abruf 07.11.2026.
Ich habe zwei Größen gerechnet, 10 Millionen und eine Milliarde Token. Beide sind Annahmen. Ich nehme eine Firma, die im Monat so viel deutschen Text verarbeitet, dass GPT darin 10 Millionen Token zählt, vier Fünftel Eingabe, ein Fünftel Ausgabe. Dazu kommen kein Rabatt, kein Zwischenspeicher für wiederholte Eingaben, der EZB-Kurs vom 05.11.2026 und für Claude der Faktor 2,11 aus dem Studientext. Bei GPT-6.1 Sol kostet dieser Text rund 32 Euro im Monat, bei Claude Sonnet 5.5 rund 68 Euro, bei Claude Opus 5.5 rund 135 Euro. Bei hundertmal so viel Text, einer Milliarde Token, sind es 3.207, 6.764 und 13.528 Euro.
Beim Anbietervergleich zählt also, was ein Text kostet. Der Preis je Token führt in die Irre. Teurer heißt trotzdem nicht schlechter, und wir bleiben bei Claude, weil es viele unserer Aufgaben gut löst.
Zähl drei eigene Texte, bevor du wählst
Meine Zahlen haben Grenzen. Die vier Blogtext-Auszüge stammen aus drei JR-Beiträgen, Claude hat sie ins Englische übersetzt. GPT zählte ich mit tiktoken statt über die Schnittstelle von OpenAI. Auf dem Studientext stimmt tiktoken mit CLEAR bis auf das Token überein. CLEAR hat gpt-6-astra über die Schnittstelle gemessen. Für GPT-6.1 Sol gilt nur meine Annahme. Daran hängt der Preisvergleich. Gemini habe ich nicht gemessen.
Nimm drei Texte aus deinem Alltag, eine Mail, ein Angebot, eine Produktbeschreibung. Schick sie durch die Token-Zählung von Anthropic und durch die Zählschnittstelle von OpenAI. Token mal Preis ergibt die Kosten je Text, danach wählst du den Anbieter je Aufgabe.
In Regensburg testen wir Modelle an echten Aufgaben, bevor sie in unsere Automatisierungen kommen, und die Token je Text gehören ab jetzt in diesen Test.
Titelbild: mit KI erzeugt (Google Gemini über Vercel), gestaltet nach unserer Bildsprache. Offenlegung: Recherchiert und geschrieben habe ich diesen Beitrag mit Claude von Anthropic.
Mehr von uns in deiner Google-Suche: JANDA+ROSCHER bei Google bevorzugen