Sonntagsgedanken vom 18. Oktober 2026
„Prolaps“, „Radikulopathie“: Wer so etwas im eigenen Befund liest, versteht oft nur die Hälfte. Was der Arzt dazu sagt, ist schnell weg: Eine Übersichtsarbeit schätzt, dass Patienten 40 bis 80 Prozent der Informationen sofort vergessen. Seit Oktober 2025 landen Befunde und Arztbriefe in der elektronischen Patientenakte, wo man sie lesen kann, bevor jemand sie erklärt hat.
Was hilft?
Ein zweiter Brief in Alltagssprache.
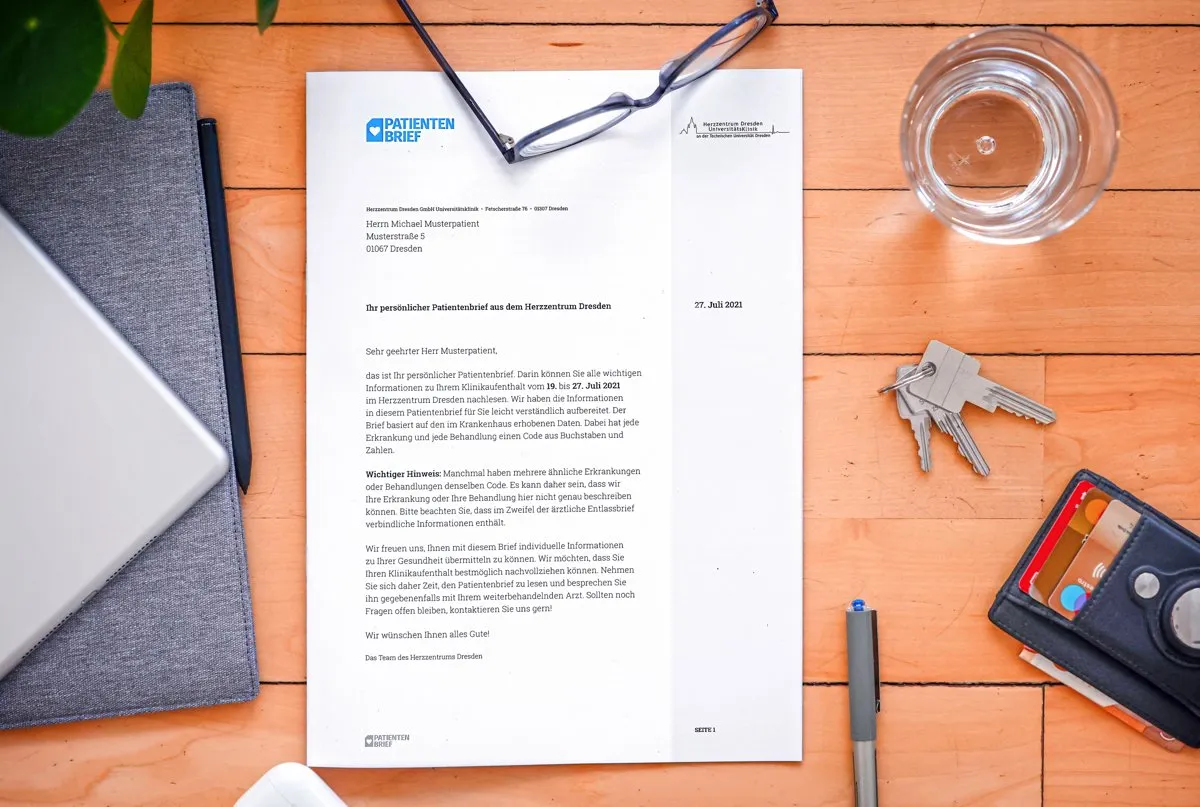
Foto: Amac Garbe, „Was hab’ ich?“. Musterbrief des Herzzentrums Dresden, Stand 2021. Die Software dahinter kommt von „Was hab’ ich?“.
Am Herzzentrum Dresden bekamen Patienten ihn 2019 und 2020 nach der Entlassung, per Los verteilt. Eine Software setzte ihn aus tausenden ärztlich geprüften Textbausteinen zusammen. Die TU Dresden wertete Fragebögen von 738 Patienten aus, 646 davon vollständig. Mit Brief kamen 44 Prozent ausreichend mit Gesundheitsinformationen zurecht, ohne Brief 32 Prozent. 93 Prozent lasen den Brief ausführlich.
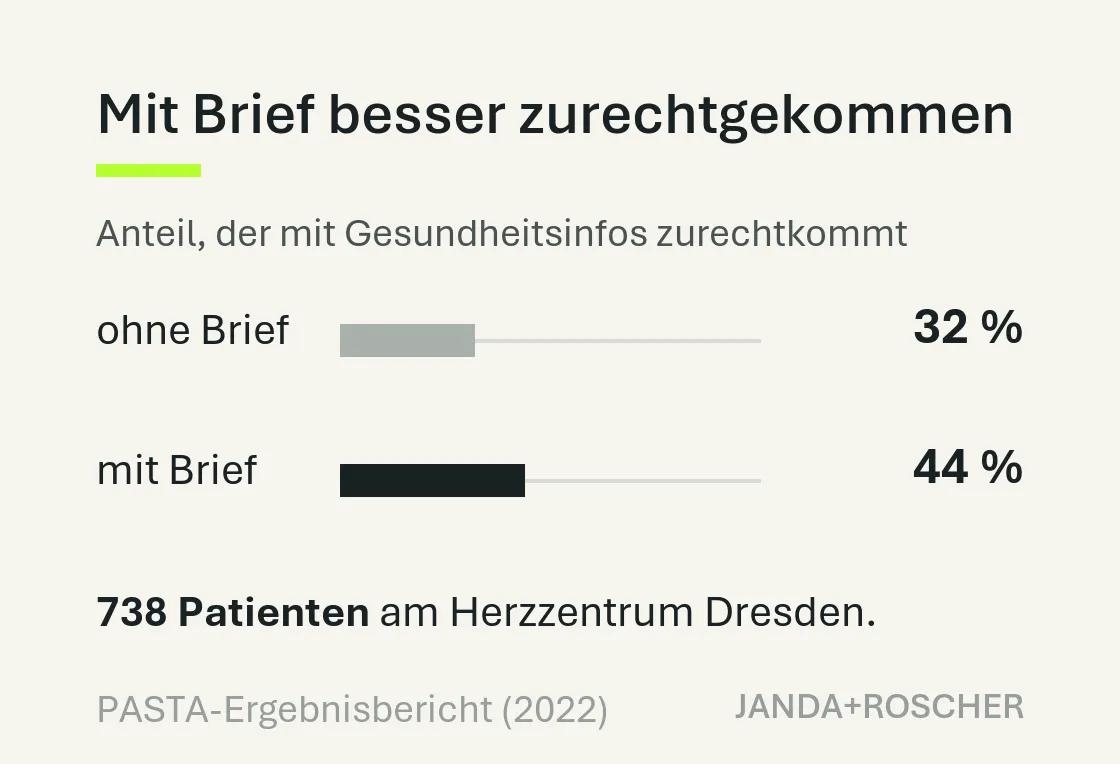
Der Innovationsausschuss, der solche geförderten Versuche bewertet, urteilte 2022: „ein positiver, wenn auch geringer Effekt“. Eine Kassenleistung für alle ist der Brief trotzdem bis heute nicht. Für alle anderen gibt es seit 2011 „Was hab’ ich?“ aus Dresden: Medizinstudierende und Ärzte schreiben dort ehrenamtlich Befunde um, über 70.000 bisher, rund 100 in der Woche, kostenlos, mit Warteliste.
Was ist neu?
Die Neurochirurgie des Universitätsklinikums hat den Befund von einer KI übersetzen lassen, für die Hälfte von 300 Patienten, vor dem Gespräch in der Ambulanz. Die Software des Berliner Start-ups Simply Onno arbeitet mit dem KI-Sprachmodell Claude. Jeder Text wurde vorher von jemandem aus dem Studienteam gegen das Original abgeglichen. Zwei Ärzte (einer von ihnen ist Mitgründer von Simply Onno) prüften nach dem Abgleich zusätzlich 75 der Texte und fanden keinen sachlichen Fehler. Die Patienten mit Übersetzung bewerteten ihr Gespräch etwas besser: 4,42 statt 4,25 von 5 Punkten, den größten Unterschied gab es beim Mitentscheiden über die Behandlung. Die Gespräche wurden kürzer. Die Ärzte selbst bewerteten sie nicht besser.
Foto: UKD/Michael Kretzschmar. Sven Richter und Elida Hasani leiten die KI-Studien der Neurochirurgie.
Erschienen ist die Studie am 15. Oktober in NEJM AI, der KI-Zeitschrift des New England Journal of Medicine. Der Vorsprung ist klein, es war eine Klinik, und ein Autor, Witold Polanski, hat Simply Onno mitgegründet.
Warum muss trotzdem jemand prüfen?
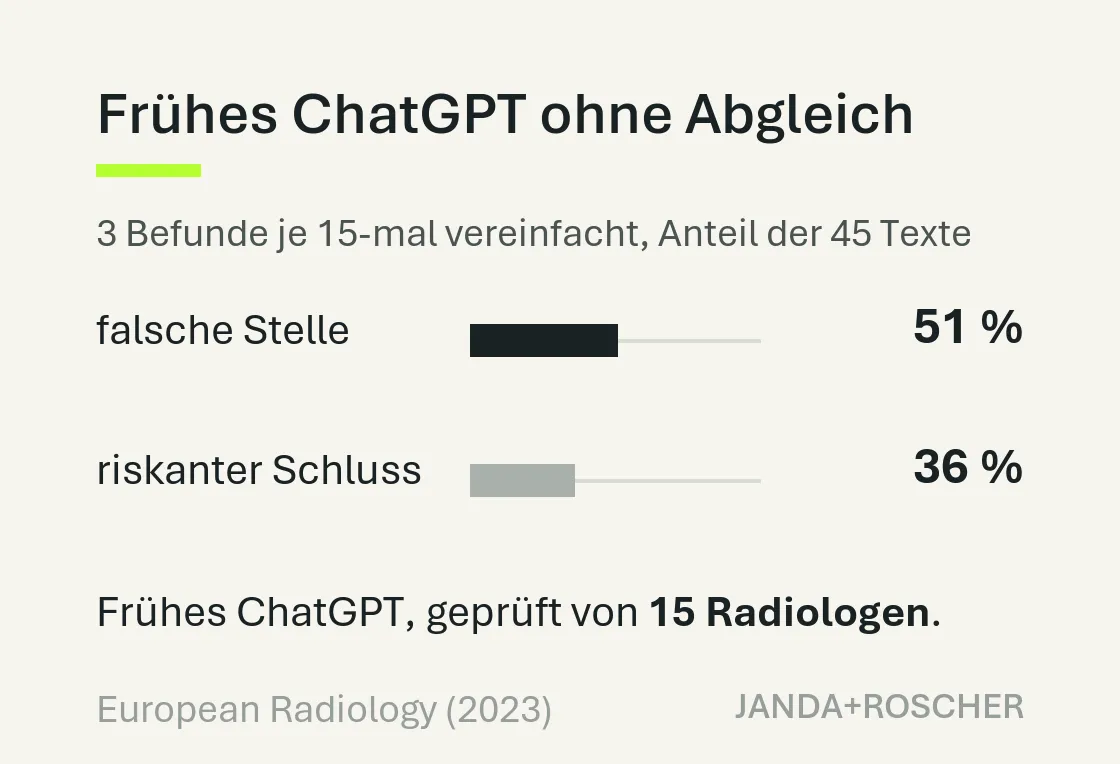
Weil ein Chatbot ohne Abgleich Fehler macht, die ein Laie nicht erkennt. Als die LMU München Ende 2022 eine frühe ChatGPT-Version drei Befunde je 15-mal vereinfachen ließ, fanden 15 Radiologen in jedem zweiten der 45 Texte mindestens eine falsche Stelle, in gut einem Drittel sogar Sätze, die zu schädlichen Schlüssen verleiten könnten. Das Modell war alt. Wie oft heutige Modelle ohne Abgleich danebenliegen, hat Dresden nicht gemessen, weil dort jeder Text vorher geprüft wurde. Wer seinen Befund selbst in einen Chatbot kopiert, hat niemanden, der den Text gegen das Original hält.
Was kann ich heute schon tun?
Die Software aus der Studie gibt es auf simply-onno.com: die einfache Zusammenfassung kostenlos, ausführlich 18,50 Euro. Persönliche Daten vorher schwärzen. Ob dort jeder Text gegen das Original geprüft wird wie in der Studie, sagt die Firma nicht; sie wirbt mit einem Ärzteteam, das laufend prüft. Wer lieber einen Menschen lesen lassen will: washabich.de, kostenlos und anonym, dafür mit Warteliste.
Was bleibt. Der Text in Alltagssprache hat Patienten in Dresden zweimal einen kleinen, messbaren Vorteil gebracht: einmal beim Verstehen nach der Entlassung, einmal im Arztgespräch. Die KI nimmt das Schreiben ab. Was drinsteht, muss ein Mensch prüfen.
Quellen: Bundesgesundheitsministerium zur elektronischen Patientenakte · Kessels, Journal of the Royal Society of Medicine (2003) · PASTA-Ergebnisbericht und Beschluss des Innovationsausschusses (2022), Riemenschneider et al., BMC Health Services Research (2025) · „Was hab’ ich?“, Pressemitteilung (15.01.2026) und washabich.de · NEJM AI, Benker-Hasani et al., AI-INFOCARE (15.10.2026) · simply-onno.com und Stiftung Deutsche Schlaganfall-Hilfe (2025) · Simply Onno, Pressemitteilung (16.10.2026) · Studienprotokoll in JMIR Research Protocols (2025) · Jeblick et al., European Radiology (online 2023)
Mehr von uns in deiner Google-Suche: JANDA+ROSCHER bei Google bevorzugen